

Carbon-X es un modelo abierto de IA de Hugging Face que permite conversar con el ADN en lenguaje natural: el usuario pregunta cómo un cambio en una secuencia genética podría afectar la actividad de los genes o la salud y recibe la respuesta en forma de chat. Con 14,000 millones de parámetros, se ejecuta de forma local en una laptop, sin enviar datos a la nube. Sus propios desarrolladores advierten que todavía no lo han validado con experimentos de laboratorio, así que su precisión es desconocida. Este artículo resume qué es Carbon-X, qué puede y qué no puede hacer, y qué lecciones deja a una empresa que trabaja con datos sensibles.
Los datos provienen del reportaje de Emily Mullin para WIRED en Español, publicado el 23 de octubre de 2026. Las cifras y declaraciones son las que reporta ese medio. Este texto es informativo y no sustituye el consejo de un profesional de la salud ni de la genética.
Carbon-X: qué es y para qué sirve
Hugging Face presentó un nuevo modelo abierto para comprender el ADN, desarrollado en colaboración con investigadores de la Academia Zhongguancun de China y de la Universidad Federico II de Nápoles, Italia. Se entrenó con secuencias genómicas y con lenguaje natural para que los usuarios puedan preguntar por los efectos de los cambios en el ADN sobre la actividad genética y la salud y obtener respuestas en forma de conversación. Lewis Tunstall, investigador científico sénior de Hugging Face, afirma que la herramienta busca ayudar a los investigadores a diseñar nuevos fármacos y terapias genéticas, y que podría ayudar a los pacientes a interpretar sus propios genomas. Según él, el uso del lenguaje natural significa que incluso usuarios sin conocimientos técnicos pueden plantear preguntas sobre el ADN a las que no tendrían acceso con ninguna otra herramienta.
Por qué el ADN se parece a un idioma
El ADN usa cuatro letras, A, C, G y T, para codificar la información, y un genoma humano contiene 6,000 millones de ellas. Aunque el genoma humano se ha secuenciado de principio a fin, los científicos aún no comprenden cómo funciona la mayor parte. Los modelos de IA están ayudando a descifrar algunos de esos misterios. La nota menciona AlphaGenome, de Google DeepMind, que predice los efectos de las secuencias de ADN y de las mutaciones genéticas en formato numérico y requiere más potencia de cálculo, y Evo 2, del Arc Institute y Nvidia junto con socios académicos, que habla el lenguaje del ADN y puede generar genomas completos desde cero. Carbon-X integra el ADN y el lenguaje natural en una interfaz conversacional, algo así como un ChatGPT para el ADN.
Cómo se entrenó y por qué es pequeño
El equipo partió de un modelo de lenguaje ya existente y amplió su vocabulario para leer el ADN en grupos de seis letras. Luego continuó el entrenamiento con 300,000 millones de fragmentos de datos, o tokens, que combinaban secuencias de ADN, texto en inglés y ejemplos que relacionaban el ADN con descripciones biológicas. Las secuencias procedían de mamíferos, incluidos los humanos, otros vertebrados, invertebrados, plantas, hongos y protozoos. Tunstall explica que no se entrenó el modelo con virus porque no querían que se utilizara para aplicaciones potencialmente peligrosas.
El modelo es deliberadamente pequeño: 14,000 millones de parámetros. La razón, según Tunstall, es que los investigadores enfrentan restricciones para cargar datos identificables o sensibles de pacientes en modelos de IA de vanguardia. Al ser pequeño, puede ejecutarse localmente en el hardware del usuario en lugar de depender de modelos en la nube, y asegura que no se envía ningún dato a Hugging Face ni a ninguna otra empresa.
Resumen visual
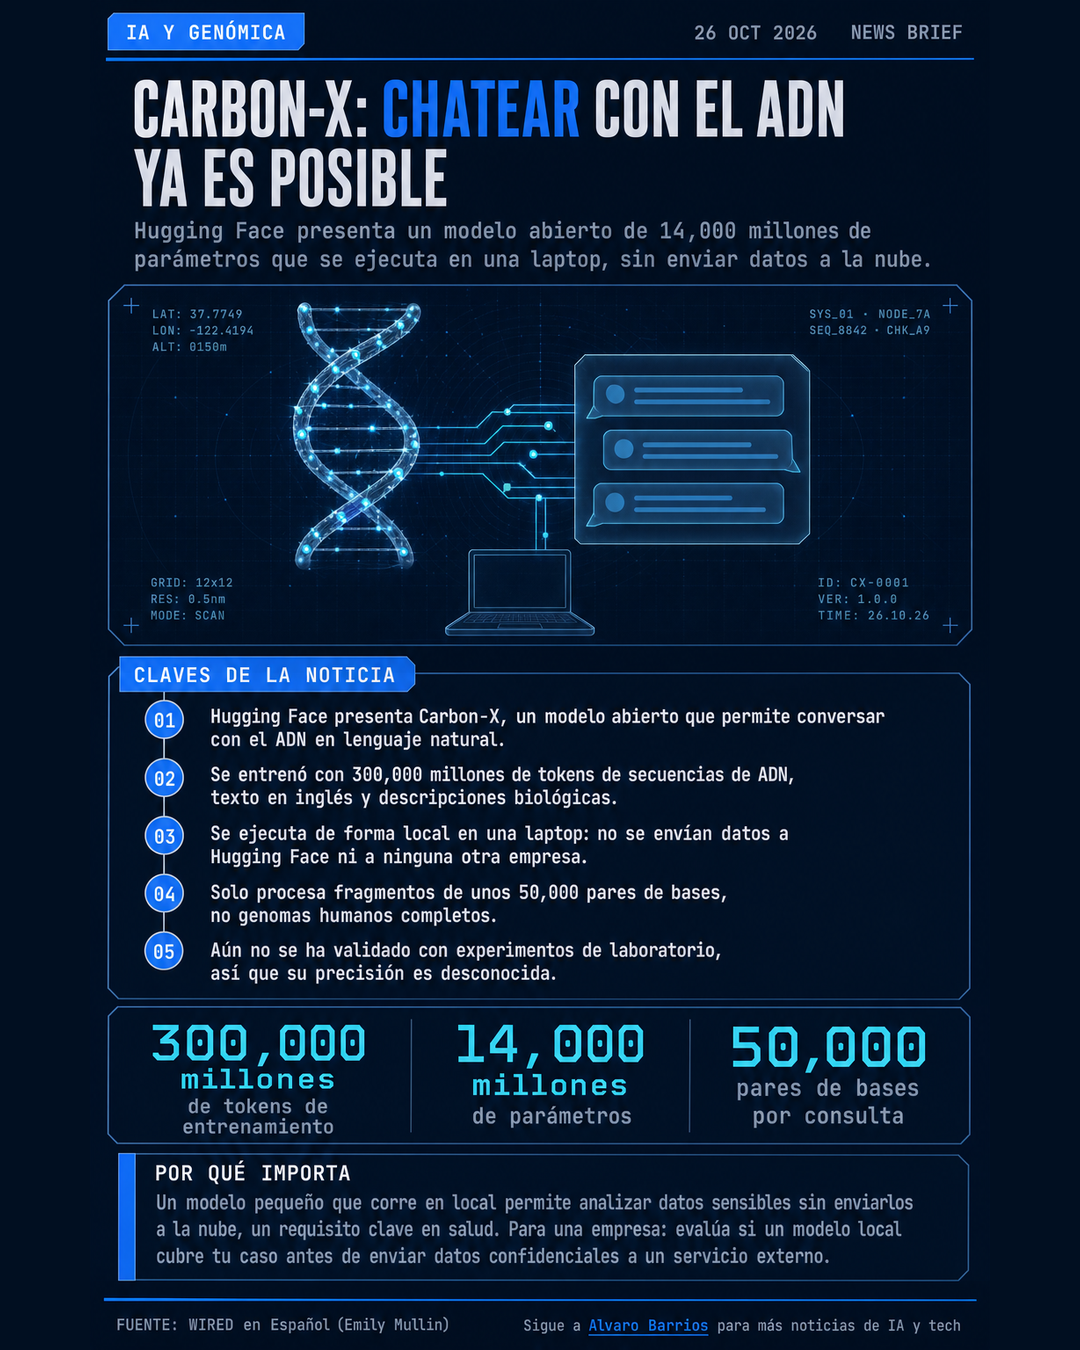
Esta infografía resume los datos clave de Carbon-X y sus límites.
Límites: fragmentos pequeños y sin validación en laboratorio
El modelo se entrenó para procesar secuencias de aproximadamente 50,000 pares de bases, de modo que los usuarios solo pueden consultar partes pequeñas del genoma cada vez; no se pueden subir genomas humanos completos. Los desarrolladores advierten, además, que aún no han validado el modelo con experimentos reales de laboratorio, por lo que no pueden afirmar con certeza qué tan precisas son sus predicciones. Una de las formas en que los científicos podrían usarlo es para ayudar a entender si una mutación genética es benigna o patógena, un paso clave en el desarrollo de un fármaco dirigido o una terapia genética: si una intervención se dirige a la mutación equivocada, podría resultar totalmente ineficaz o, peor, causar daños no deseados.
Qué significa para tu empresa
Tu empresa probablemente no analiza genomas, pero Carbon-X ilustra decisiones que cualquier empresa enfrenta al adoptar IA con datos sensibles. Son cuatro recomendaciones de Infinitix y no conclusiones de la nota.
- Considera modelos pequeños y locales cuando los datos son sensibles. Si manejas información de clientes, nómina o contratos, un modelo que corre en tu equipo evita enviar datos a un tercero. Evalúa si cubre tu caso antes de recurrir a un servicio en la nube.
- No confundas modelo abierto con modelo validado. Que el código y los pesos estén disponibles no garantiza su precisión. Los propios autores reconocen que falta validación; prueba con casos tuyos antes de depender de los resultados.
- Fija límites de uso desde el diseño. El equipo excluyó virus del entrenamiento para limitar usos peligrosos. En tus automatizaciones, define qué datos no se usan y qué acciones no se permiten.
- Pon el lenguaje natural al servicio del equipo no técnico. La ventaja que destaca la nota es que personas sin conocimientos técnicos pueden hacer preguntas complejas. Un asistente interno con tus propios documentos puede dar ese mismo acceso a tu equipo.
Y en IA y esquizofrenia: cómo el habla podría adelantar el diagnóstico vimos cómo cambian los datos sensibles cuando se usan en salud.
Para ver cómo se evalúa un sistema de IA antes de confiar en él, revisa nuestro análisis del informe de la OCDE sobre la IA gubernamental en México.
En Infinitix diseñamos agentes de IA y automatizaciones que se prueban con datos reales y respetan los límites de privacidad de cada empresa. Conoce nuestros servicios de agentes de IA o cómo automatizar procesos con IA.
Lo que la nota no dice
La nota no presenta pruebas independientes ni cifras de precisión de Carbon-X, y los propios desarrolladores reconocen que falta validarlo en laboratorio. Tampoco detalla requisitos de hardware más allá de que puede ejecutarse en una laptop, ni fechas o condiciones de uso para pacientes. Conviene tratar el lanzamiento como una herramienta de investigación en etapa temprana y no como una herramienta clínica o de diagnóstico.
Preguntas frecuentes
¿Qué es Carbon-X?
Es un modelo abierto de Hugging Face para comprender el ADN. Se entrenó con secuencias genómicas y lenguaje natural para que los usuarios puedan preguntar por los efectos de los cambios en el ADN sobre la actividad genética y la salud y recibir respuestas en forma de conversación.
¿Quién lo desarrolló?
Hugging Face, en colaboración con investigadores de la Academia Zhongguancun de China y de la Universidad Federico II de Nápoles, Italia, según la nota de WIRED.
¿Cómo se entrenó?
El equipo partió de un modelo de lenguaje existente, amplió su vocabulario para leer el ADN en grupos de seis letras y continuó el entrenamiento con 300,000 millones de tokens que combinaban secuencias de ADN, texto en inglés y ejemplos que relacionaban el ADN con descripciones biológicas. No se usaron virus para evitar aplicaciones potencialmente peligrosas.
¿Se ejecuta en la nube o en mi equipo?
Con 14,000 millones de parámetros se diseñó para ejecutarse de forma local en el hardware del usuario, incluso una laptop. Según Hugging Face, no se envía ningún dato a la compañía ni a ninguna otra empresa.
¿Qué límites tiene?
Solo procesa secuencias de unos 50,000 pares de bases, así que se consultan partes pequeñas del genoma cada vez, y los desarrolladores advierten que aún no lo han validado con experimentos reales de laboratorio, por lo que no pueden afirmar con certeza qué tan precisas son sus predicciones.
¿Qué puede aprender una empresa de este lanzamiento?
Que un modelo pequeño y local puede ser una opción cuando los datos son sensibles, que conviene validar cualquier modelo con casos propios antes de confiar en él y que se pueden fijar límites de uso desde el diseño. Es una recomendación nuestra, no una conclusión de la nota.
Conclusión
Carbon-X muestra una dirección interesante para la IA: modelos abiertos, pequeños y locales que permiten conversar con datos complejos como el ADN sin enviarlos a la nube. También muestra el límite: todavía no se ha validado con experimentos reales. Para tu empresa, la lección es evaluar si un modelo local cubre tu caso, validar antes de confiar y fijar límites de uso desde el diseño. Fuente: WIRED en Español.