


La IA en la ciencia está avanzando rápido en los problemas teóricos: según un estudio del MIT, entre mediados de 2024 y mediados de 2026 los mejores modelos pasaron de resolver correctamente alrededor del 2% a aproximadamente el 35% de los problemas teóricos de varios campos científicos. Los investigadores sugieren que la probabilidad, la economía teórica, la física de altas energías, la cosmología y la física cuántica podrían ser los siguientes campos en transformarse, y advierten que la IA puede equivocarse y que hace falta verificar sus resultados. Este artículo resume el estudio, sus límites y qué lecciones deja a una empresa que ya usa IA.
Los datos provienen del reportaje de Will Knight para WIRED en Español, publicado el 15 de octubre de 2026. Las cifras y declaraciones son las que reporta ese medio; no revisamos el estudio original.
IA en la ciencia: qué encontró el estudio del MIT
Will Knight asistió la semana pasada a una conferencia en el MIT de Neil Thompson, quien estudia los avances en informática e IA, y la resume así: en media hora expuso de forma convincente que varios campos científicos están a punto de ser revolucionados por la IA. Mientras los matemáticos se muestran molestos porque la IA automatiza su campo, el último estudio de Thompson sugiere que la probabilidad, la teoría estadística, la teoría económica, la teoría de las altas energías, la gravitación y la cosmología, así como la física cuántica, podrían ser los siguientes. El resultado central es que, entre mediados de 2024 y mediados de 2026, los mejores modelos de IA pasaron de resolver correctamente alrededor del 2% de los problemas teóricos de estos campos a resolver aproximadamente el 35%, y no hay indicios de que ese progreso vaya a ralentizarse, según los autores.
Cómo se hizo la prueba
El estudio lo realizó Thompson junto con Gabriel Manso, estudiante de doctorado, y Claudio Mayrink Verdun, investigador científico. Tomaron problemas planteados en artículos de investigación publicados en línea entre diciembre de 2025 y mayo de 2026 y comprobaron si varios modelos de OpenAI (o1, o3, GPT-5, GPT-5.1, GPT-5.4 y GPT-5.5) eran capaces de resolverlos. Las soluciones aparecían en artículos publicados después de la fecha límite de entrenamiento de GPT-5.5 y de los modelos anteriores, así que los modelos tuvieron que encontrarlas por sí mismos y no repetir respuestas aprendidas. Además, los investigadores bloquearon el acceso a internet para que no pudieran buscarlas en línea.
Un alcance limitado a propósito
El análisis se centró en campos donde los modelos podían resolver problemas sin necesidad de simulaciones o experimentos. Aun así, el trabajo sugiere que este enfoque podría extenderse a otros campos de la investigación científica con un fuerte componente matemático y teórico.
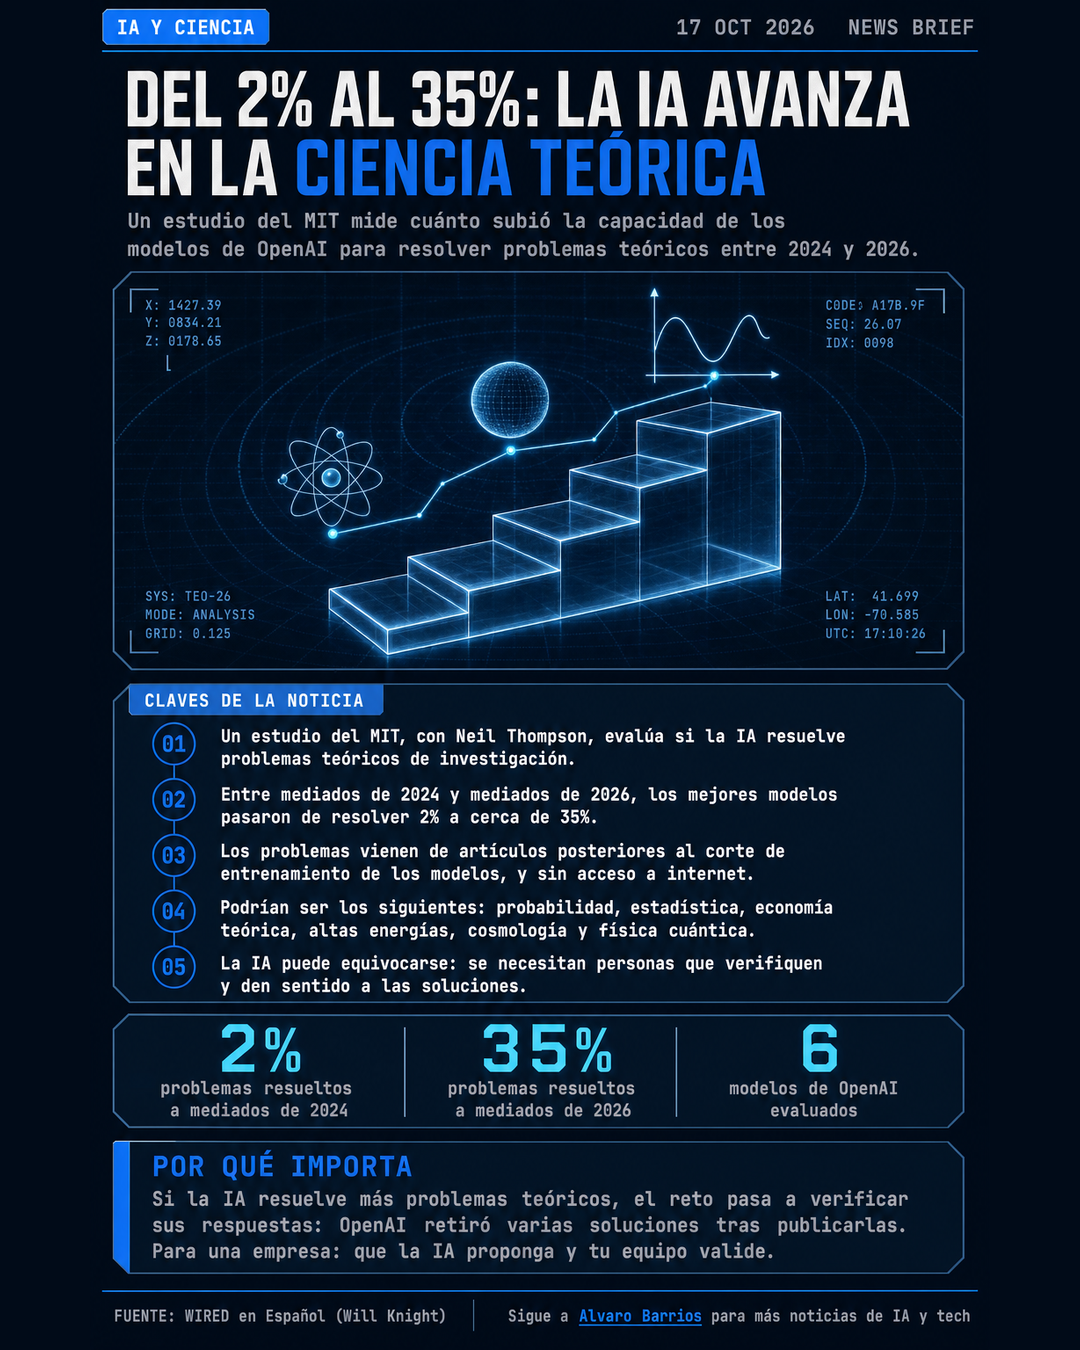
Resumen visual
Esta infografía resume los datos clave del estudio y sus límites.
El contexto: de los problemas del milenio a la crisis de las matemáticas
La nota recuerda que en septiembre OpenAI anunció que un modelo aún no publicado había resuelto un importante desafío matemático de larga data, el de las ecuaciones de Navier-Stokes, que describen el movimiento de los fluidos. El episodio fue polémico después de que un matemático de la Universidad de Nueva York, que trabajaba con otro académico vinculado a Anthropic, acusara a OpenAI de adelantarse tras enterarse de su progreso. Desde entonces, OpenAI y otros han anunciado cientos de soluciones más a problemas matemáticos de larga data, lo que ha desatado una especie de crisis en el campo. Algunos matemáticos han pedido poner límites al uso de la IA, porque el proceso de resolver un problema suele ser tan útil como tener la respuesta final. Thompson afirma que, como en las matemáticas, hay que esperar efectos positivos y negativos en otras áreas, y que los avances teóricos a veces impulsan avances prácticos en la ciencia.
Las advertencias: la IA puede equivocarse
Algunos destacados investigadores de IA han fundado nuevos laboratorios centrados en la IA para la ciencia, y los grandes laboratorios están intensificando su investigación científica para explorar cómo llevar la IA a hacer experimentos reales junto con el análisis teórico. Los investigadores afirman que eso no implica que dejen de hacer falta expertos para dar sentido a las soluciones y garantizar que sean sólidas. Manso lo resume diciendo que se seguirá necesitando a personas que generen buenas ideas. Añade que, ante problemas muy complejos, la IA puede cometer errores: de hecho, OpenAI retiró varias soluciones de su último conjunto de datos tras publicarlo. Por eso también hacen falta formas de verificar lo que se ha hecho, porque es muy fácil que un modelo afirme que tiene la respuesta correcta y que, al revisar la solución completa, se descubra que quizá no lo sea.
Qué significa para tu empresa
Tu empresa probablemente no resuelve problemas de física teórica, pero este estudio deja cuatro lecciones para evaluar y usar herramientas de IA, sea en una PyME o en una empresa mediana. Son recomendaciones de Infinitix y no conclusiones de la nota.
- Evalúa con casos que la herramienta no haya visto. El estudio usó problemas posteriores al corte de entrenamiento y sin internet. Al probar una herramienta, usa casos nuevos de tu operación, no los ejemplos de la demostración.
- El cuello de botella se mueve hacia la verificación. Si la IA genera más respuestas, define quién las revisa, con qué criterio y qué pasa cuando hay un error. Que la IA proponga y una persona valide.
- Repite tus evaluaciones. Pasar de 2% a 35% en dos años muestra que la capacidad cambia rápido. Una prueba que hiciste el año pasado puede ya no representar lo que la herramienta hace hoy.
- Pide pruebas en tu contexto real. El estudio se limitó a campos sin experimentos. Para procesos con clientes, inventarios o pagos, valida con una muestra de tus datos reales antes de ampliar.
Si te interesa el debate sobre cómo controlar y supervisar estos sistemas, lee nuestro análisis de la carta de más de 400 científicos sobre seguridad de la IA.
Para ver cómo se evalúa un sistema de IA antes de confiar en él, revisa nuestro análisis del informe de la OCDE sobre la IA gubernamental en México, y para ver qué puede hacer hoy una de estas herramientas, nuestro artículo sobre Gemini y la creación de documentos.
En Infinitix diseñamos agentes de IA y automatizaciones que se prueban con datos reales y mantienen supervisión humana. Conoce nuestros servicios de agentes de IA o cómo automatizar procesos con IA.
Lo que la nota no dice
La nota no detalla cuáles fueron los problemas concretos ni cómo se calificó cada respuesta, y el estudio evaluó solo modelos de OpenAI, por lo que no permite comparar con los de otras compañías. Tampoco aclara si el 35% se mantiene en cada campo por separado. Las cifras son las que reportan los autores y la propia nota señala que el alcance fue limitado. Conviene tratar los resultados como una señal de tendencia y no como una medida definitiva.
Preguntas frecuentes
¿Qué midió el estudio del MIT sobre IA y ciencia?
Midió qué porcentaje de problemas teóricos de investigación podían resolver correctamente los modelos de IA. Según la nota de WIRED, entre mediados de 2024 y mediados de 2026 los mejores modelos pasaron de resolver alrededor del 2% a aproximadamente el 35% de esos problemas.
¿Quiénes hicieron el estudio?
Neil Thompson, que estudia los avances en informática e IA en el MIT, junto con Gabriel Manso, estudiante de doctorado, y Claudio Mayrink Verdun, investigador científico.
¿Cómo evitaron que los modelos copiaran las respuestas?
Tomaron problemas de artículos publicados en línea entre diciembre de 2025 y mayo de 2026, posteriores al corte de entrenamiento de GPT-5.5 y de los modelos anteriores, y bloquearon el acceso a internet para que no pudieran buscar las soluciones.
¿Qué campos podrían ser los siguientes?
Según el estudio, la probabilidad, la teoría estadística, la teoría económica, la teoría de las altas energías, la gravitación y la cosmología, y la física cuántica. El análisis se limitó a campos donde los modelos podían resolver problemas sin simulaciones ni experimentos.
¿Significa que la IA reemplazará a los científicos?
No según los autores. Señalan que se seguirán necesitando expertos para dar sentido a las soluciones, comprobar que sean sólidas y generar buenas ideas. Además, ante problemas muy complejos la IA puede cometer errores.
¿Qué debe aprender una empresa de este estudio?
Que conviene evaluar las herramientas de IA con casos que no haya visto, que el cuello de botella se mueve hacia la verificación y que los resultados mejoran rápido, así que las evaluaciones deben repetirse. Es una recomendación nuestra, no una conclusión de la nota.
Conclusión
El estudio del MIT muestra que la IA en la ciencia avanza rápido en los problemas teóricos y que el siguiente reto es verificar lo que produce. Los propios autores piden personas que generen ideas y comprueben las soluciones. Para tu empresa, la lección es probar las herramientas con casos nuevos, repetir las evaluaciones y mantener a alguien que valide. Fuente: WIRED en Español.